AI 검색 ‘추천 목록 1위’인데 데모가 안 늘었다 — GEO 점수와 계약 사이의 3가지 단절
AI 검색 ‘추천 목록 1위’인데, 데모 예약이 늘지 않았다
B2B SaaS 마케터 한 명이 최근 이런 고민을 털어놨다. AI 검색 대시보드를 열면 브랜드가 어느 LLM에서든 추천 목록에 오르고, GEO(Generative Engine Optimization) 점수도 분기 최고를 찍었다. 근데 데모 예약 수는 반년째 제자리다. “AI 검색에서 안 보이던 때보다 더 잘 보이는데, 왜 파이프라인은 그대로죠?” 이 질문의 답은 단순한 충격이 아니라 마케팅 전략 전체의 읽는 법을 바꾼다.
BrightEdge 조사에 따르면 산업을 막론하고 68%의 브랜드가 AI 검색 파도에 맞춰 검색 전략을 바꾸는 중이다. ChatGPT가 출시된 지 3년이 지났으니 놀랄 숫자는 아니다. 문제는 그 68%가 대부분 “어떻게 하면 AI 검색에 나오나”만 묻고, “나오면 무엇이 바뀌나”를 묻지 않는다는 점이다. 그 사이에서 “AI 검색 노출 = 수요”라는 방정식이 무비판적으로 받아들여진다. 그런데 그 방정식은 정확히 세 곳에서 깨진다.
Search Engine Land의 Adam Tanguay가 정리한 “3 key AI search limitations for B2B SaaS marketing”은 GEO가 못 하는 일을 정면으로 다룬 드문 기사다. 이 글은 그 외부 기사의 세 가지 한계를 “GEO 지표가 거짓말하는 지점”으로 다시 읽고, 각 지점을 실제 워크플로에서 메우는 방법까지 풀어본다.
GEO 지표가 거짓말하는 3가지 지점
세 한계를 한 줄로 요약하면 이렇다. AI 검색은 인지도가 없는 것을 만들지 못하고, 전문가가 원하는 깊이를 주지 못하고, 스스로 검증되지 못한다. 각각이 대시보드 지표와 실제 파이프라인 사이의 단절 지점이 된다.
한계 1. 신제품은 ‘없는 것처럼’ 취급된다
전통 SEO든 PPC든 검색 마케팅은 원래 신제품·신규 버티컬에 인지도를 만들어주는 장치가 아니다. 의도 기반(intent-based) 구조는 “사용자가 이미 뭔가를 알고 있어야 검색이 성립”한다는 전제 위에 서 있다. AI 검색도 이 전제를 그대로 물려받는다. 그리고 거기에 한 겹이 더 쌓인다.
AI 검색은 콘텐츠를 직접 수집하지 않고 전통 검색엔진이 먼저 인덱싱하기를 기다려야 한다. 그 순서 때문에 신규 콘텐츠가 AI 검색 결과에 표면화되는 속도는 전통 검색보다 더 느리다. 무슨 뜻이냐면, 신제품을 출시한 직후가 성장이 가장 필요한 시점인데 바로 그 시점이 AI 검색에서 가장 안 보이는 시점이라는 뜻이다. 레퍼런스도, 평가 데이터도, AI가 인용할 권위 있는 구절도 없으니까. 그리고 대시보드는 애초에 ‘없는 것’을 측정하지 못한다. 신제품은 지표 자체가 공백으로 남는다.
대응은 전통 검색과 같다. Tanguay가 말하는 트로이 목마(Trojan horse) 전략 — 신제품을, 이미 인지도가 정착된 쿼리·테마에 연결하는 것. “새 카테고리를 열겠다”가 아니라 “기존 카테고리 안의 새로운 해법”으로 접근해야 AI가 발견할 수 있는 지점에 들어선다. 인지도가 없는 땅에 씨앗을 심는 건 AI 검색에서 특히 더 느리게 자란다.
한계 2. 전문가 질문에는 일반론을 돌려준다
B2B 구매는 이커머스처럼 짧고 직선적이지 않다. CFO부터 어카운트 코디네이터까지, 배경이 다른 구매위원회 전원이 확신해야 한다. 그리고 이게 AI 검색이 가장 약한 영역이다. Tanguay의 표현이 정확하다. “AI 검색은 건초더미 속 바늘 찾기에는 탁월하지만, 건초더미를 설계하지는 못한다.”
“낮은 금리를 유지하면서 홈에퀴티를 활용하는 방법” 같은 구체적인 질문은 모델이 정확히 집어준다. 그런데 “창고를 현대화하는 최선의 방법은 무엇인가” 같은 전략적 질문으로 넘어가면, 답은 뻔한 일반론이다. 회사의 규모, 예산, 목표라는 개별 컨텍스트를 모델이 반영하지 못하기 때문이다. 여기에 환각(hallucination) 리스크가 겹치면, 깊이를 요구하는 B2B 의사결정에서는 그 오류가 곧바로 신뢰의 실패로 이어진다. 다자 구매위원회를 설득해야 하는 자리에서 AI가 준 일반론만으로는 아무도 확신하지 않는다.
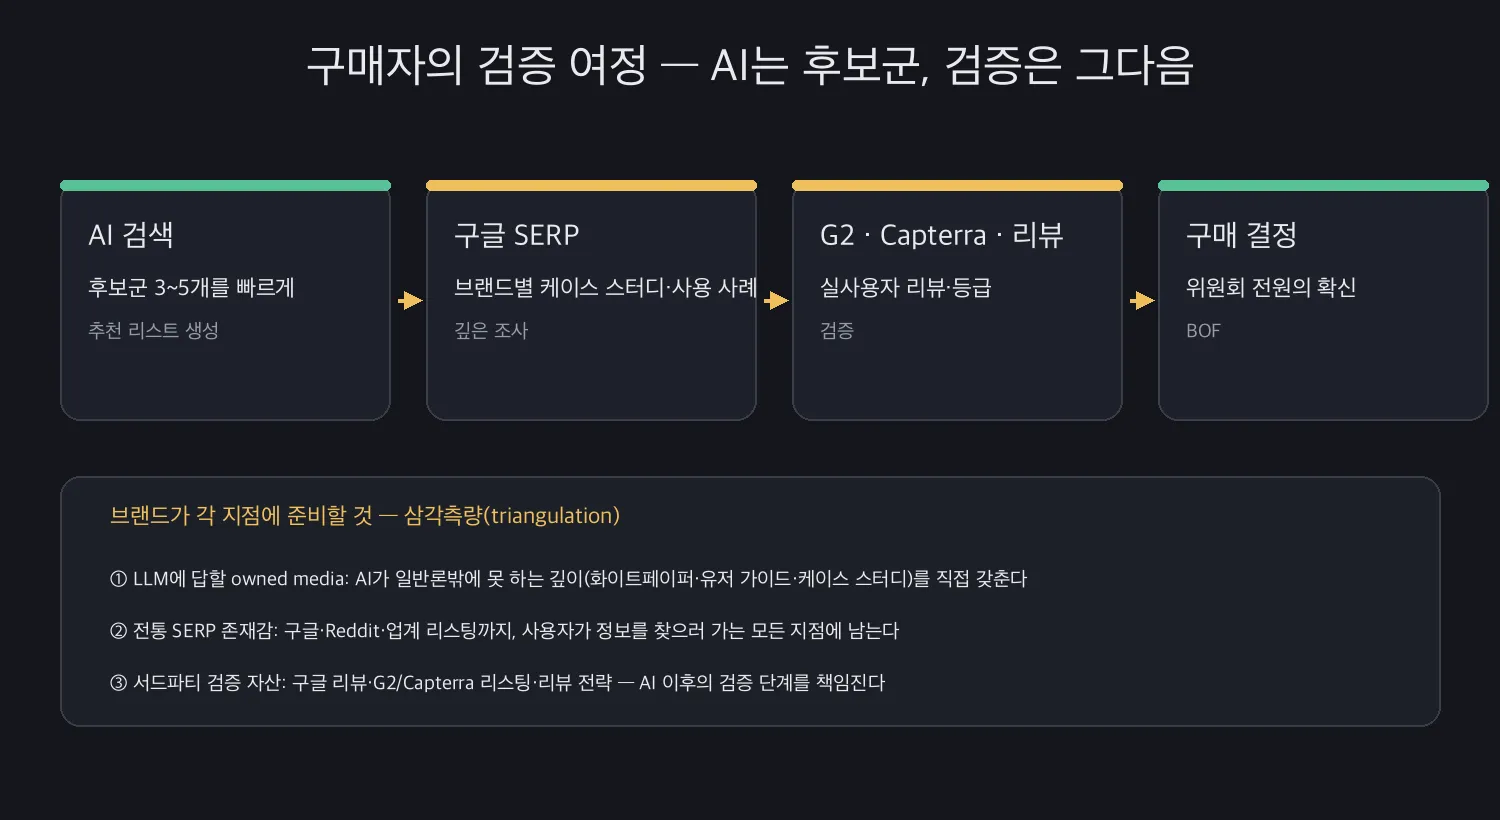
대응은 삼각측량(triangulation)이다. 사용자가 정보를 찾으러 가는 모든 지점 — LLM, 구글, Reddit, 업계 리스팅, 그리고 특히 owned media(자사 미디어) — 에 깊이 있는 콘텐츠(화이트페이퍼, 유저 가이드, 케이스 스터디)를 직접 만들어 유통하는 것. AI가 일반론을 답하는 동안, 당신은 그 깊이를 직접 판매하고 있어야 한다.
한계 3. ‘추천 1위’는 평판이 아니라 GEO의 결과다
세 번째 한계가 가장 미묘하면서 치명적이다. 객관성의 부재. Google의 AI Overviews가 스스로 “우리 결과가 ChatGPT보다 더 신뢰받는다”고 말한 적이 있다. 그 주장 자체보다 재미있는 건, 그 평가가 편향된 주체(구글)의 입에서 나왔다는 것이다. 이 아이러니가 객관성 문제의 정수다. AI 검색은 출처를 항상 인용하지 않으며, “업계 최고 제공업체 목록을 보여줘” 같은 질문에 나오는 답변은 목록에 포함된 업체들의 정보를 끌어온 결과일 가능성이 높다. 즉 그 추천은 “탁월함을 인정받았다”가 아니라 “GEO를 잘 했다”를 반영한 것에 가깝다.
사용자가 LLM에게 출처를 요구하면 링크 목록을 받는다. 하지만 그 행동은 사람들이 LLM을 쓰는 이유와 정면으로 배치된다. 사람들은 소화하기 쉬운 답 하나를 원하지, 교차 검증할 링크 디렉토리를 원하지 않는다. 고려 대상 후보군(consideration set)을 빠르게 만드는 능력은 확실하다. 다만 거기에는 검증(verification)과 사회적 증거(social proof)가 빠져 있다. Tanguay의 팀 데이터가 이를 뒷받침한다. ChatGPT 출시 이후에도 바텀오브퍼널(BOF) 리서치는 여전히 구글 리뷰, G2·Capterra 리스팅, 브랜드 케이스 스터디에 의존하지 AI 검색 결과에 의존하지 않는다.
대응은 사용자처럼 생각하는 것이다. LLM이 한계에 부딪히면 사람들은 어디로 가서 검증할까. 그 장소에 자산을 쌓아라. 서드파티 리뷰·리스팅 전략, 케이스 스터디, 그리고 영업팀과의 협력을 통해 “ChatGPT가 답하지 못하는 질문에 답하는 owned media”를 갖추는 것. 이 조각들이 없으면 미드펀넬에서 바텀펀넬로 넘어가는 순간 전환이 새어 나간다.
핵심 통찰: GEO 점수는 수익 지표가 아니라 ‘퍼널 한 칸’의 지표다
세 한계를 지도 위에 올려놓으면 하나의 그림이 나온다. AI 검색은 퍼널에서 딱 한 칸 — 고려 대상 후보군 생성 — 만 담당한다. 인지도(상단)와 검증(하단)에서는 태생적으로 약하다. “AI 검색에 나온다”는 사실이 계약까지 이어지려면, 그 앞뒤 칸이 다른 채널로 채워져 있어야 한다.
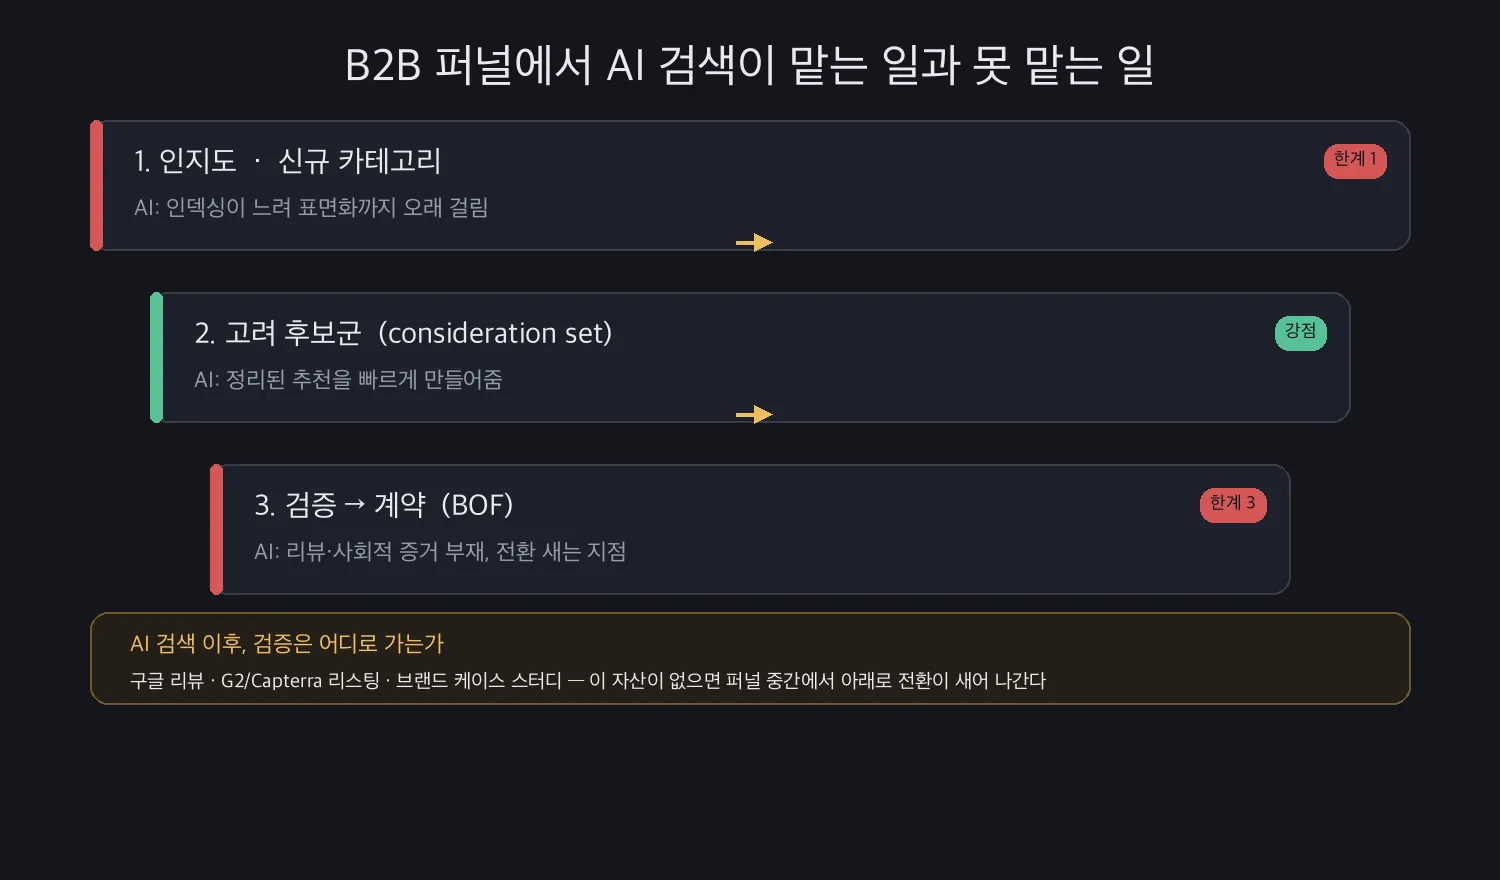
그렇다면 세 한계는 더 이상 “불행한 단점”이 아니라 전환 누수 체크포인트가 된다. 점수가 올랐는데 파이프라인이 그대로라면, 새는 곳은 셋 중 하나다. ① 신제품이 인지도가 없는 땅에서 AI 노출을 기대하고 있는가. ② 구매위원회가 확신할 만한 깊이의 콘텐츠가 owned media에 없는가. ③ 사용자가 AI 이후에 가는 검증 장소(구글 리뷰·G2·Capterra·케이스 스터디)에 자산이 없는가. 이 셋이 각각 트로이 목마 전략, 삼각측량, 검증 자산으로 연결된다.
내 워크플로에서는 이렇게 쓴다
여기서부터는 외부 기사가 아니라 내 작업 경험이다. 나는 콘텐츠·검색 파이프라인을 운영하면서, SEO 기사 하베스터가 수집한 자료에 큐레이션 점수를 매겨 주제를 선별한다. 이 기사도 그 과정에서 점수 0.80을 받고 선별됐는데, 선택 이유는 단순했다. “GEO가 잘하는 것”만 모은 기사보다 “GEO가 못하는 것”을 정리한 기사가 실무에서 더 쓸모 있다고 판단했기 때문이다.
실제로 내 파이프라인에서도 이 프레임워크가 작동한다. 첫째, 신규 주제는 독립 카테고리로 시작하지 않고 이미 순위가 잡힌 키워드 클러스터에 연결해 출발시킨다 — 트로이 목마다. 둘째, 퍼블리싱 이후에는 AI 가시성 점검과 전통 SERP 점검을 병행해, AI가 일반론을 돌려주는 질문에는 owned media의 깊이 콘텐츠가 대응하는지 확인한다 — 삼각측량이다. 셋째, BOF 자산(케이스 스터디, 검증 페이지)은 AI 최적화 목표에서 일부러 분리해 관리한다. AI 검색과 전통 검색을 한 묶음으로 관리하고, 각 채널이 못 하는 지점을 다른 채널이 메우는 구조를 만드는 것이다.
이 방식이 준 가장 큰 이득은 하나다. “AI 검색에 안 나온다”는 단일 지표에 좌우되지 않게 됐다는 것. GEO 점수는 인지·고려 지표이지 수익 지표가 아니라는 해석이 팀의 기본값이 되면, 지표가 오르락내리락해도 예산과 인력을 흔들지 않는다. 대신 “어느 퍼널 칸이 비었는지”를 기준으로 배분한다.
이번 분기 GEO 보고서에 3가지 질문을 붙여라
지금 하고 있는 일을 멈추지 말고, 이번 분기 GEO 보고서에 체크리스트 한 장을 덧붙여보길 권한다. 첫째, 신제품을 AI 검색으로 인지도를 키우려 하고 있지 않은가 — 그렇다면 기존 테마에 연결하는 트로이 목마 콘텐츠부터 점검하라. 둘째, 구매위원회가 확신할 만한 깊이의 콘텐츠가 owned media에 존재하는가 — AI가 일반론을 답하는 동안 당신은 케이스 스터디와 유저 가이드로 깊이를 판매하고 있어야 한다. 셋째, 사용자가 AI 검색 이후에 가는 곳, 즉 구글 리뷰·G2·Capterra에서 당신을 찾을 수 있는가 — 검증 자산이 없으면 미드펀넬에서 바텀펀넬로 넘어가는 순간 전환이 새어 나간다.
세 질문 중 하나라도 답이 애매하다면, 그 지점이 곧 경쟁자가 파고들 자리다. 68%의 브랜드가 GEO로 달려갈수록, 그 구멍을 알고 메우는 브랜드의 차별화는 더 커진다. AI 검색 노출은 계약의 전제가 아니다. 퍼널의 각 칸이 제 역할을 할 때, 비로소 노출이 파이프라인으로 연결된다. 직접 적용해본 경험이 있다면, 특히 어느 지점에서 전환이 새는 것을 목격했는지 댓글로 공유해달라.
근거 출처
[외부 정보 (하베스터 수집)] 본문의 세 가지 한계(신규 카테고리 인지도 불가, 전문가용 세밀한 조언 부재, 객관성 부재), BrightEdge의 “68% 브랜드 검색 전략 변경” 수치, “AI search can find the needle but it can’t design the haystack” 비유, 트로이 목마 전략, 삼각측량(triangulation), AI Overviews의 “구글 결과가 더 신뢰받는다” 주장, “top 공급업체 목록은 GEO의 결과”라는 해석, “ChatGPT 출시 이후에도 BOF 리서치는 여전히 구글 리뷰·G2·Capterra·케이스 스터디에 의존”이라는 저자 팀 데이터, “사용자가 LLM이 한계에 부딪힌 뒤 가는 곳에 자산을 쌓아라”는 제안은 모두 Adam Tanguay가 Search Engine Land에 게재한 “3 key AI search limitations for B2B SaaS marketing”(2025-10-16)을 바탕으로 정리했다.
[상호작용 (에이전트-드루 대화·작업)] “내 워크플로에서는 이렇게 쓴다” 섹션은 내 콘텐츠·검색 파이프라인 운영 경험을 1인칭으로 서술한 것이다. 이 기사의 선별 과정(하베스터 큐레이션, 점수 0.80)과 키워드 클러스터 연결·AI/SERP 병행 점검·BOF 자산 분리 관리 방식, 그리고 “GEO 점수는 수익 지표가 아니라 퍼널 한 칸의 지표”라는 해석 프레임은 외부 기사가 아닌 내 작업 기록에서 온 내용이다.