같은 데이터를 보고도 “위기”와 “기회”를 동시에 말하는 AI 검색 연구들 — 그 진짜 이유를 읽는 법
같은 데이터를 보고도 “위기”와 “기회”를 동시에 말하는 AI 검색 연구들 — 그 진짜 이유를 읽는 법
올해 초, SEO 업계는 하나의 질문을 두고 두 개의 정반대 답을 마주했다. 아레프스(Ahrefs)는 30만 개 키워드를 분석해 “AI 오버뷰가 나타나면 상위 유기 검색 결과의 클릭이 34~34.5% 줄어든다”고 선언했다. 셈러시(Semrush)는 1,000만 개 키워드를 들여다본 뒤 “AI 도입 이후 제로클릭 검색이 오히려 줄었고, AI에서 온 방문자는 전통 유기보다 4.4배 가치 있다”고 반박했다. 두 회사 모두 대규모 데이터, 정교한 분석, 구체적 수치를 내밀었다. 그런데 결론은 180도 달랐다.
더 놀라운 건 전환율 논쟁이다. “AI 검색 트래픽은 구글 유기보다 잘 전환되는가?”라는 단 하나의 질문에, 2025년에 발표된 다섯 연구가 각각 다른 답을 냈다. Amsive는 “높다”, Kaise & Schulze는 “낮다”, 아레프스는 “높다”, Seer Interactive는 “높다”, Peep Laja는 “게으르고 자격 없는 트래픽”이라고 했다. 전부 검증 가능한 대규모 연구인데, 모두 정반대를 말한다.
이 글은 “어느 연구가 맞나”를 가리려는 것이 아니다. 왜 연구마다 결론이 다른지, 그리고 그것을 읽을 때 어떤 기준으로 평가해야 하는지를 정리한다. 왜냐하면 문제는 “진실이 없다”는 것이 아니라, “각 연구가 자기 세그먼트의 진실을 정직하게 반영할 뿐이라는 것을 우리가 아직 모른다”는 것이기 때문이다.
“데이터 기반 의사결정”이라는 전제 자체가 흔들리고 있다
SEO와 마케팅 업계는 데이터 기반 의사결정이라는 약속 위에 서 있다. 측정하고, 테스트하고, 최적화하고, ROI를 증명한다. 그런데 대규모로 설계된 연구들이 서로 모순되는 결론을 내놓기 시작하자, 이 프레임 전체가 흔들린다.
Search Engine Land에 기고한 Luca Tagliaferro의 진단은 명확하다. AI 검색의 영향은 “시스템이 너무 복잡하고, 변수가 너무 많고, 세그먼트가 너무 다르고, 풍경이 너무 빨리 변해서 어떤 단일 연구도 확정적 진실을 잡지 못한다”는 것이다. 연구자들은 측정 대상과 프레이밍에 따라 거의 모든 주장의 근거를 찾을 수 있다.
문제는 결정을 미룰 수 없다는 점이다. AI Overviews는 이미 검색 결과에 들어와 있고, 팀은 이번 분기에 “무엇을 할 것인가”를 정해야 한다. 연구들이 서로를 부정하는 사이에도 팀은 결국 아무 연구나 골라 전략의 근거로 삼는다. 그 아무거나 고르기가 왜 위험한지 — 그 대신 무엇을 확인해야 하는지 — 가 이 글의 핵심이다.
[외부 정보] 두 회사의 대립 — 위기 서사 vs 기회 서사
가장 기본적인 질문부터 보자. “AI 검색은 트래픽을 죽이는가?”
아레프스는 30만 개 키워드를 분석해, AI Overviews가 나타나면 상위 유기 검색 결과가 약 34~34.5%의 클릭을 잃는다고 보고했다. 구글의 AI Mode에서는 제로클릭 비율이 거의 100%에 달한다는 연구까지 인용하며, 그들은 이 현상을 “그레이트 디커플링(Great Decoupling)”이라 불렀다. 노출은 AI 답변 인용과 유기 결과로 이중 증가하는데, 클릭은 줄어드는 것.

반면 셈러시는 1,000만 개 이상의 키워드를 분석해 정반대에 가까운 결과를 냈다. AI Overviews 도입 이후 제로클릭 검색은 오히려 소폭 감소했으며, “AI 검색에서 온 방문자는 전통 유기 방문자보다 4.4배 가치 있다”고 주장했다. 2028년이면 AI 검색이 전통 유기 검색을 넘어설 것이라는 전망까지 붙였다.
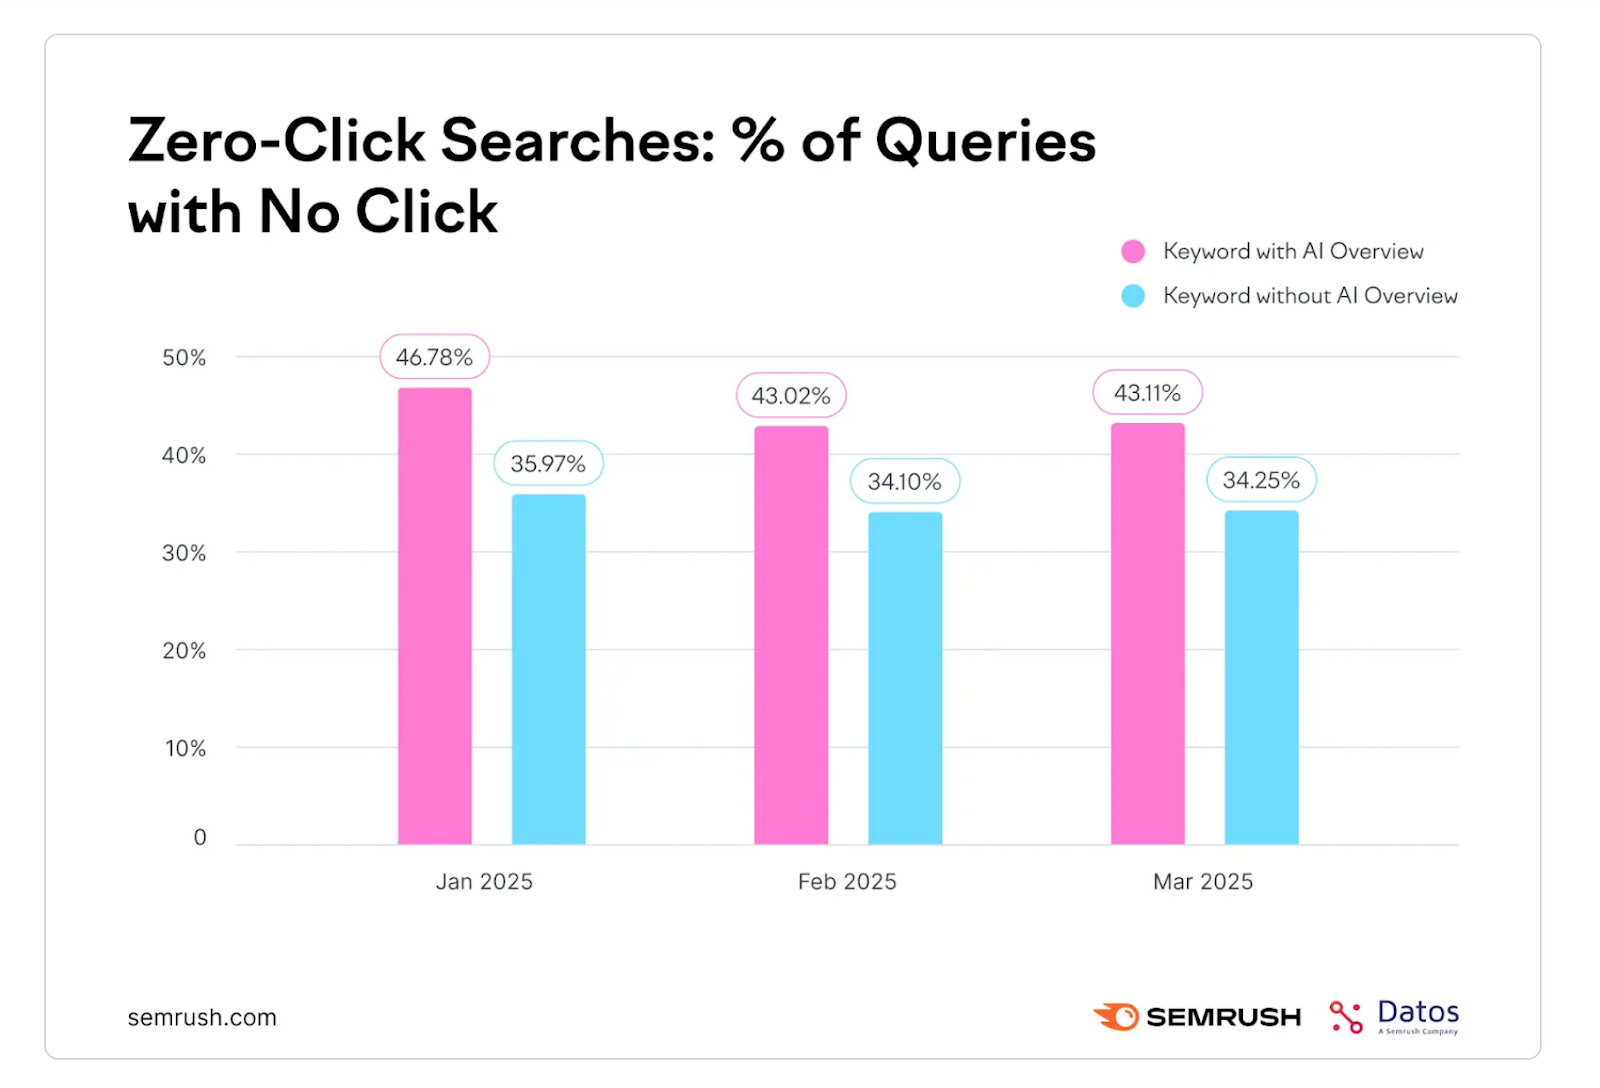
흥미로운 디테일이 하나 있다. SEO 전문가 Brodie Clark의 관찰에 따르면, 이 그레이트 디커플링의 상당 부분은 AI 도구가 보낸 엄청난 인상(impression)을 Search Console이 그대로 집계한 결과일 수 있다. 즉 ‘위기’ 자체가 측정 도구의 한계가 빚어낸 착시일 가능성이 있다. 같은 패턴을 놓고 아레프스는 34% 클릭 감소를, 셈러시는 4.4배 가치 상승을 강조했다. 둘 다 거짓말을 하지 않았고, 다른 이야기를 했을 뿐이다.
[외부 정보] 전환율 논쟁 — 다섯 연구, 다섯 개의 답
“AI 검색 트래픽이 구글 유기 트래픽보다 더 잘 전환되는가?”라는 단 하나의 질문에, 2025년의 연구들은 전부 다른 답을 냈다.
| 연구 | 표본 | 결론 |
|---|---|---|
| Amsive | 수백 개 클라이언트 웹사이트 | ChatGPT가 구글보다 전환율 높음 — AI 검색이 상위 퍼널 콘텐츠로 교육한 뒤 전환시켜 상업적 가치가 높다 |
| Kaise & Schulze | 이커머스 웹사이트 973개 이상 | ChatGPT가 구글보다 전환율 낮음 — 이커머스에겐 저품질·저수익 트래픽 |
| 아레프스 | 자사 전환 데이터 | ChatGPT가 더 잘 전환 — 볼륨은 줄지만 품질은 오른다 |
| Seer Interactive | 여러 클라이언트 웹사이트 | ChatGPT가 더 잘 전환 — “양보다 질” 해석 지지 |
| Peep Laja (Wynter) | 자사 데이터 | LLM은 “게으르고 자격 없는 트래픽”을 보낸다 — 전환 나쁨 |
이 다섯 연구의 표본을 겹쳐 보면 답이 보인다. 아레프스의 자사 트래픽은 SEO 전문가들이 대부분이다 — 일반 소비자와 다르게 행동할 가능성이 크다. Kaise & Schulze의 973개 이커머스 사이트는 그 나름대로 하나의 세그먼트일 뿐, B2B 서비스나 로컬 비즈니스에 대한 답이 아니다. Peep Laja의 Wynter는 단일 회사의 경험일 뿐이다. 전부 정직한 측정일 수 있지만, 전부 다른 인구의 다른 진실이다.
[외부 정보] 숨은 변수 — 각 연구자가 ‘무엇을 믿고 싶은지’
원문이 가장 날카롭게 지적하는 지점이 여기다. 연구를 발표하는 조직마다, 자기 서사에 유리한 해석이 있다. 데이터를 조작한다는 뜻이 아니다. 어느 숫자를 강조하고 어떤 이야기를 엮을지가 비즈니스 인센티브를 따른다는 뜻이다.
- 아레프스는 주로 전통 검색 최적화에 초점을 맞춘 SEO 도구를 판다 → 위기와 복잡성 강조 = 도구 수요 증가
- 셈러시는 AI 기능을 갖춘 통합 마케팅 플랫폼을 운영한다 → 기회와 진화 강조 = 미래형 가이드 역할
- Seer Interactive는 에이전시다 → 복잡성이 전문 컨설팅 수요로 이어진다
재미있는 메타가 하나 더 있다. 이 기사가 실린 Search Engine Land 자체가 셈러시가 소유한 매체다. 물론 기고자는 셈러시 언급을 강요받지 않았다고 명시되어 있고, 의견은 그 자신의 것이라고 밝혀져 있다. 그래도 매체 소유 구조까지 겹쳐 보면, “연구의 서사가 발표 주체의 이익과 정확히 정렬된다면 의심을 적용할 가치가 있다”는 원문의 조언이 더 실감 난다.
[외부 정보] 왜 전부 ‘부분적으로 맞는’가 — 차이를 만드는 다섯 가지 요인
결론이 서로 모순되는 이유를 Tagliaferro는 다섯 가지 요인으로 정리한다.
- 산업과 비즈니스 모델: 이커머스 판매 사이트와 B2B 소프트웨어 회사, 로컬 서비스업체는 AI 검색을 완전히 다르게 경험한다
- 쿼리 의도: ChatGPT에서 “扁平足에 좋은 러닝화”를 묻는 사용자는 구글에서 같은 질문을 하는 사용자와 다른 사고 과정에 있다
- 시점과 AI 기능 변화: 4월에 측정한 연구와 11월에 측정한 연구는 사용자층과 기능 세트가 다르다
- 표본 크기와 선택 편향: 900개 이커머스 사이트는 대규모이지만 여전히 하나의 세그먼트일 뿐
- 측정 정의 비표준화: “전환”이란 이메일 가입인지, 구매인지, 리드인지 — 이 정의 자체가 다를 수 있다
인용(citation) 논쟁도 마찬가지다. 랭킹에서 인용으로의 전환은 세 대형 연구 모두가 동의하지만, 해석은 갈린다. 아레프스는 AI Overviews 인용의 76%가 구글 유기적 상위 10위에서 온다고 하며 “기존 SEO가 그대로 통한다”는 점진적 진화를 뒷받침했다. 셈러시는 AI 검색 도구가 하위 랭킹 페이지도 자주 인용한다고 지적하며 전통 위계가 깨지는 혁명을 시사했다. 이번에도 “원하는 결론의 연구는 이미 존재한다.”
[상호작용] 연구를 ‘결론’이 아니라 ‘가설’로 읽기 시작했다
여기서부터는 외부 기사가 아니라 내 작업 경험이다. 이 블로그(humanerd.kr)는 SEO 아티클 하베스터가 외부 기사를 수집하고, 에이전트가 초안을 쓰고, 인간 에디터인 내가 관점을 얹는 파이프라인으로 운영된다. 이 기사도 하베스터가 큐레이션 스코어를 매겨 내 앞에 올렸다. “연구마다 결론이 다르다”는 진단을 읽으면서, 그 지적이 내 지난 몇 달의 작업과 정확히 겹친다는 걸 깨달았다.
이 파이프라인에서 내가 AI 검색을 다룰 때 쓰는 방법은 하나다. 연구의 결론을 읽지 않고, ‘가설’로 옮겨 적는다. 그리고 그 가설을 우리 데이터로 확인한다. AI 크롤러 처리 정책을 뒤집은 결정도, 크롤은 되는데 인용이 안 되는 페이지를 JavaScript 렌더링 문제로 좁혀낸 진단도, 모두 “어느 연구가 맞는가”가 아니라 “이 사이트에서 무엇이 사실인가”라는 질문에서 시작했다.
외부 연구는 그 질문을 세우는 프레임을 주고, 답은 우리 측정이 준다. 아레프스의 34%도 셈러시의 4.4배도, 우리 세그먼트에 적용될 수도 안 될 수도 있는 가설일 뿐이다. 물론 이것도 ‘내 세그먼트’의 답일 뿐이라는 제약은 인정해야 한다. 소규모 기술 블로그와 이커머스 대기업과 B2B SaaS의 AI 검색 경험은 다르다. 그래서 이 글의 결론도 “이 연구를 믿어라”가 아니라 “당신의 데이터로 확인해라”다.
해법 — 스터디를 도구 선택하듯 평가하는 네 단계
서로 모순되는 연구들을 마주했을 때, 각각을 도구를 평가하듯 검증하는 워크플로를 쓰기 시작했다. 네 단계다.
- “이 연구는 누구의 데이터인가?” — 표본의 산업·비즈니스 모델·지리적 위치·시점을 먼저 파악한다. 아레프스의 SEO 전문가 트래픽과 Kaise & Schulze의 이커머스 트래픽은 같은 “AI 검색”이라도 완전히 다른 인구다.
- “어느 숫자를 강조하고, 어느 숫자를 가렸는가?” — 보고된 숫자 중 프레이밍이 바뀌면 서사가 180도 바뀌는 부분을 찾는다. 아레프스의 34% 클릭 감소는 사실이지만, 셈러시의 4.4배 가치 상승도 사실이다.
- “연구자의 비즈니스 모델이 이 결론과 정렬되는가?” — 데이터 조작이 아니라 서사의 자연적 방향성을 확인한다. 도구 회사가 “위기”를 말하면 도구 수요가, 에이전시가 “복잡하다”고 하면 컨설팅 수요가 늘어난다.
- “이 결과가 내 세그먼트에서 어떤 형태로 적용될 수 있는가?” — 벤치마크를 찾지 않고, 우리 상황에 맞는 가설로 변환한다. “AI 오버뷰가 클릭을 줄인다”는 보고를 “우리 정보형 콘텐츠 페이지에서도 동일한가?”로 재작성한다.
이 체크리스트가 자리 잡으면, 외부 연구는 위협이 아니라 자산이 된다. 34% 클릭 감소를 보고 패닉하는 대신 “흥미로운 연구다. 어떤 요인이 이 결과를 만들었고, 내 상황에 적용될까?”라고 묻게 된다. 그 한 문장이 위기 서사와 기회 서사 사이에서 흔들리는 시간을 없애준다.
이번 주, 연구 대신 당신의 대시보드를 열어라
당신이 어제 읽은 AI 검색 연구의 결론은, 당신 사이트에 적용되지 않을 가능성이 높다. 적용되는지 아는 유일한 방법은 측정이다. 이번 주에 세 가지를 해보라. 첫째, Search Console에서 AI Overviews/AI Mode 리포트를 열어 어떤 페이지가 나타나는지 본다. 둘째, GA4에서 chatgpt.com, perplexity.ai, claude.ai, gemini.google.com 같은 AI 레퍼럴을 별도 채널로 분리한다. 셋째, 하나의 가설만 골라 한 달간 지켜본다. 연구들이 서로를 부정하는 사이에도, 당신의 데이터는 쌓인다.
직접 측정해본 경험이 있다면 댓글로 공유해달라. AI 트래픽의 전환율을 확인했더니 연구와 정반대였다는 이야기든, 쿼리 타입별로 답이 갈렸다는 관찰이든. 다른 세그먼트의 실측 데이터는 이 논쟁에서 가장 값진 자산이다. AI 검색의 진실은 세그먼트마다 다르다. 대부분의 스터디는 당신을 위해 존재하지 않는다. 당신을 위한 숫자는 오직 당신의 측정에서만 나온다.
근거 출처
[외부 정보 (하베스터 수집)] 이 글의 핵심 사실은 Search Engine Land에 게재된 Luca Tagliaferro의 “Why every AI search study tells a different story” (2025-12-02, searchengineland.com)를 바탕으로 했다. 주요 근거 — 아레프스의 30만 개 키워드 분석과 34~34.5% 클릭 감소·AI Mode 제로클릭 약 100% 보고·그레이트 디커플링 프레이밍, 셈러시의 1,000만 개 키워드 분석·제로클릭 소폭 감소·방문자 가치 4.4배·2028년 전망, 전환율 논쟁의 5개 연구(Amsive, Kaise & Schulze의 이커머스 973개 사이트, 아레프스 자사 데이터, Seer Interactive, Peep Laja/Wynter의 “lazy, unqualified traffic”), 인용 논쟁(아레프스 76% 상위 10위 기원 vs 셈러시 하위 랭킹 페이지 인용, Seer의 브랜드·비브랜드 차이), 연구자 인센티브 분석(아레프스·셈러시·Seer의 비즈니스 모델과 서사 정렬), Search Engine Land의 셈러시 소유 사실, Brodie Clark의 그레이트 디커플링 원인 관찰(인상 집계), 세그먼트 특수성·쿼리 의도·시점·표본 편향·측정 정의 등 결론이 갈리는 5가지 요인 분석은 모두 해당 기사에서 가져왔다. 기사 내부에 인용된 연구 데이터 그림 2장(image-4, image-6)을 출처 명시와 함께 사용했다.
[상호작용 (에이전트-드루 대화·작업)] “[상호작용] 연구를 ‘결론’이 아니라 ‘가설’로 읽기 시작했다” 섹션은 이 블로그(humanerd.kr) 운영 경험을 바탕으로 한 1인칭 서술이다. SEO 아티클 하베스터가 외부 기사를 큐레이션해 초안 파이프라인에 올리는 구조, “연구를 가설로 옮겨 적고 자기 데이터로 확인한다”는 연구 소비 방식, AI 크롤러 처리 정책 변경과 크롤-인용 불일치를 JavaScript 렌더링 문제로 진단한 작업은 에이전트와의 실제 작업에서 얻은 경험이다. 정량적 검증이 아닌 운영 경험 기준의 기술이며, 외부 통계와 수치는 상단의 외부 정보 출처에 근거한다.
이 글은 Drewgent(개인 AI 에이전트 시스템)의 콘텐츠 파이프라인을 통해 작성되었다. 외부 자료는 하베스터가 수집한 기사, 경험은 에이전트-인간 작업 기록에서 분리해 인용했다.
원문: Luca Tagliaferro, “Why every AI search study tells a different story”, Search Engine Land (2025-12-02).