AI가 우리 브랜드를 틀리게 말한다면, 모델 말고 출처부터 고쳐라
AI가 우리 브랜드를 틀리게 말해도, 고객은 정정해주지 않는다
고객이 ChatGPT나 Perplexity에 우리 제품을 물었다고 해보자. AI가 가격을 틀리게 말하거나, 이미 없앤 기능을 아직 제공한다고 설명하거나, 경쟁사의 기능을 우리 제품에 붙여 말한다. 고객은 그 답변에 이의를 제기하지 않는다. 조용히 다음 브랜드를 찾아간다. 우리가 잃은 건 틀린 문장 하나가 아니라, 아직 발생하지 않은 방문과 매출이다.
그래서 브랜드 관리의 질문이 바뀌어야 한다. “AI가 우리를 언급하는가?”가 아니라 “AI가 우리를 어떤 근거로, 누구에게 맞는 브랜드라고 설명하는가?”를 물어야 한다.
한 번의 검색으로는 브랜드의 AI 인식을 알 수 없다
[외부 정보 (하베스터 수집)] Semrush의 가이드에 따르면 ChatGPT, Google AI Overviews, Perplexity는 제품 리서치와 브랜드 비교의 첫 관문이 됐다. 그런데 세 플랫폼은 같은 질문에도 서로 다른 답을 내놓고, 모델이 업데이트되면 어제의 답이 오늘 바뀐다. 내 브랜드명을 한 번 검색해서 괜찮은 답을 봤다고 안심하는 건, 한 명의 고객에게 한 번만 설문하고 전체 시장의 평판을 안다고 말하는 것과 같다.
더구나 오류는 브랜드명 질문에서만 나오지 않는다. “이 회사가 뭘 하는가?”에는 맞게 답하면서도 “소규모 팀에 맞는 도구는?”에서는 빠질 수 있다. 제품명 질문에서는 단종된 가격을 말하고, 경쟁사 비교에서는 다른 회사의 기능을 우리 기능처럼 붙일 수도 있다. 브랜드·제품·카테고리 질문을 따로 점검해야 하는 이유다.
AI가 틀리는 방식에는 출처가 있다
AI의 오류를 “환각”이라고만 부르면 고칠 방법이 사라진다. Semrush가 정리한 대표적인 오류는 네 가지다. 오래된 정보(단종 제품·이전 가격), 만들어진 세부사항(존재하지 않는 기능·잘못된 창업 연도), 경쟁사 정보의 오귀속, 그리고 제품 누락이다.
원인은 대개 웹 어딘가에 있다. 리뷰 사이트의 낡은 설명, Reddit나 Quora의 오래된 글, 업데이트되지 않은 업계 디렉터리, 경쟁사 비교 글, “최고의 도구” 목록, 소셜 게시물이 AI의 재료가 된다. 공식 홈페이지는 그중 하나일 뿐이다. 외부 페이지에 같은 주장이 더 자주, 더 오래 반복됐다면 AI는 그쪽을 더 그럴듯한 근거로 받아들일 수 있다.
AI 답변을 고치는 가장 빠른 길은 AI에게 다시 물어보는 것이 아니라, 그 답변을 만든 출처까지 거슬러 올라가는 것이다.
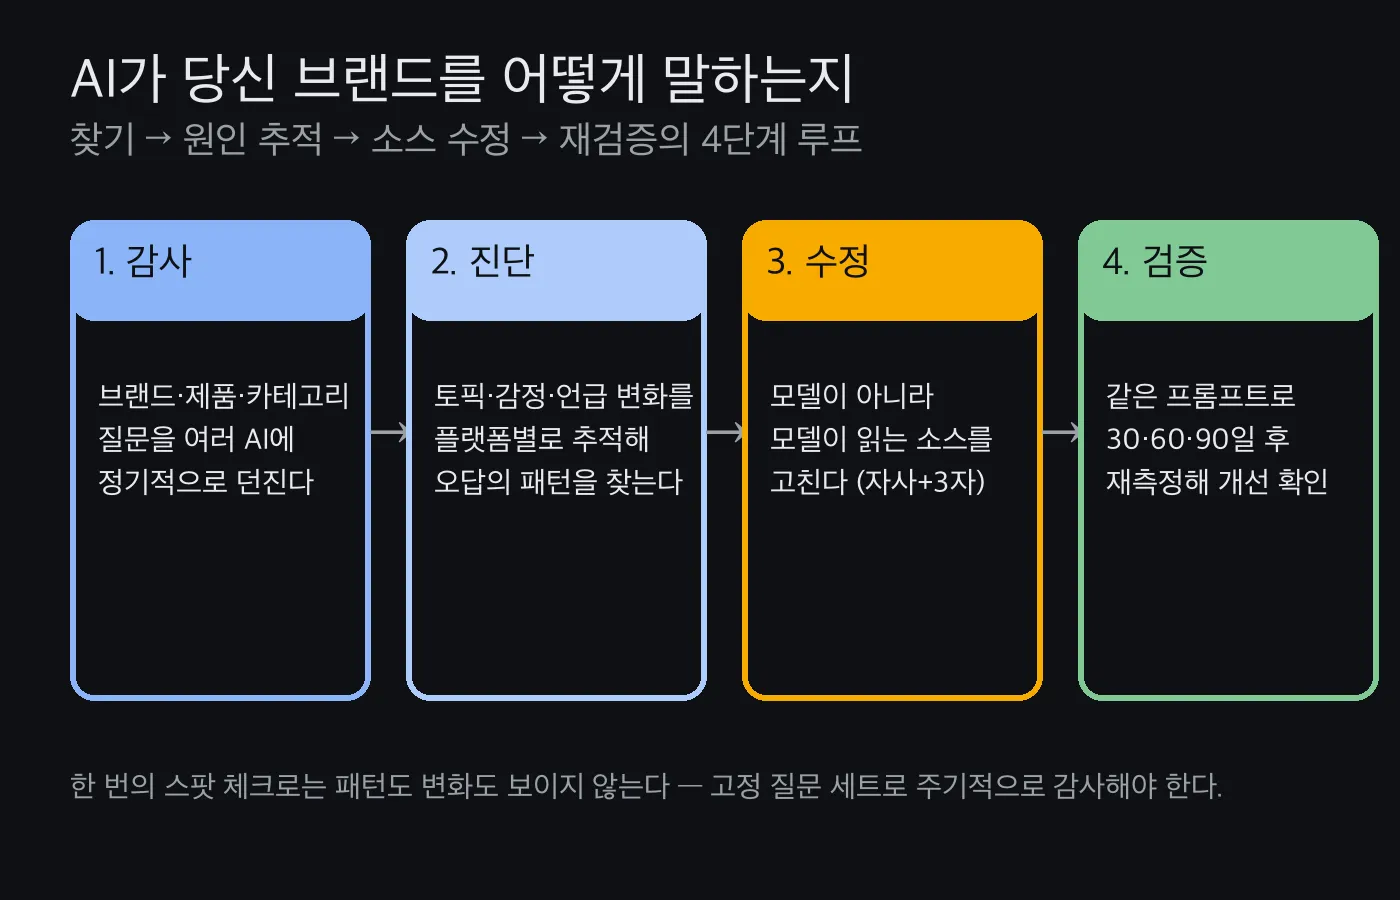
정답을 되찾는 실전 루프: 감사 → 진단 → 수정 → 검증
이제 도구를 고르는 것보다 먼저 반복 가능한 루프를 만든다. 질문 세트를 고정하고, 플랫폼을 고정하고, 결과를 기록하면 “느낌상 좋아졌다”를 실제 변화로 바꿀 수 있다.
- 감사한다. 브랜드 질문 3개, 핵심 제품 질문 3개, 카테고리·비교 질문 4개처럼 10개의 고정 프롬프트를 만든다. ChatGPT·Perplexity·Gemini 등에서 같은 날 실행하고 답변, 언급 여부, 출처 링크를 저장한다.
- 진단한다. “언급되지 않음”과 “틀리게 언급됨”을 분리한다. 오류 문장에 붙은 인용 링크와 반복해서 등장하는 도메인을 찾는다. 감정이 부정적인지, 핵심 제품이 빠졌는지, 경쟁사 기능이 섞였는지도 표시한다.
- 소스를 수정한다. 우리 홈페이지의 제품·가격·소개·FAQ부터 사실과 날짜를 맞춘다. 그다음 리뷰 사이트, 디렉터리, 비교 글의 운영자에게 정정을 요청하고, 필요하면 최신 정보가 담긴 독립적인 자료를 만든다. 플랫폼의 신고 버튼은 보조 수단이지 주된 해결책이 아니다.
- 검증한다. 같은 프롬프트를 30·60·90일 뒤 다시 실행한다. 멘션 빈도만 보지 말고 사실 정확도, 감정, 제품별 노출을 함께 비교한다. AI 응답의 변화는 플랫폼에 따라 수주에서 수개월 걸릴 수 있다.
도구는 감사 습관을 확장할 때만 값어치를 한다
Semrush의 AI Visibility Toolkit은 2억 1,300만 개 프롬프트 데이터베이스를 기반으로 여러 AI 플랫폼의 멘션, 감정, 토픽 연관성, 응답 변화를 추적한다고 설명한다. 도메인을 넣은 뒤 “Your Performing Topics”에서 토픽별·플랫폼별 응답을 직접 읽고, Prompts에서 어떤 질문과 출처가 브랜드를 만들고 있는지 확인하는 방식이다.
이 도구의 핵심은 점수가 아니다. AI가 우리를 어떻게 말하는지 원문 답변과 출처까지 읽게 해준다는 점이다. Narrative Drivers에서는 브랜디드 인용과 답변을 열어 어떤 제3자 소스가 서사를 밀고 있는지 찾을 수 있고, Perception에서는 AI가 붙인 속성 표현을 확인할 수 있다. 다만 구독부터 할 필요는 없다. 스프레드시트와 스크린샷 폴더로 10개 질문을 2주만 기록해도, 우리 브랜드의 첫 오류 목록은 나온다.
홈페이지보다 먼저 고칠 곳이 따로 있을 수 있다
오류를 발견하면 자사 페이지 하나를 고치고 끝내기 쉽다. 하지만 AI가 반복해서 인용하는 페이지가 낡은 리뷰나 비교 글이라면, 우리 사이트의 새 문장만으로는 부족하다. 오류가 나온 답변에서 출처를 추출하고, 영향이 큰 도메인부터 정정하는 순서가 효율적이다. “모든 웹을 고치자”가 아니라 반복 인용되는 소스부터 고치자가 실행 가능한 전략이다.
자사 사이트에서는 홈페이지의 한 문장짜리 정체성, 제품 페이지의 현재 가격·기능·대상 사용자, About 페이지의 기본 사실, FAQ의 평이한 답변을 먼저 정리한다. Google Search Central도 홈페이지에 Organization 구조화 데이터를 두고 이름·URL·로고·공식 프로필 같은 식별 정보를 일관되게 제공하라고 권장한다. 이것이 AI를 즉시 바꾸는 버튼은 아니지만, 브랜드 엔티티를 혼동하지 않게 하는 정본 레이어다. 마크업은 반드시 실제 화면의 사실과 일치해야 한다.
오늘 30분이면 첫 번째 오류를 찾을 수 있다
지금 브랜드명만 검색하지 말고, 고객이 실제로 묻는 질문을 10개 적어라. “우리 제품의 가격은?”, “소규모 팀에 맞는가?”, “A와 B 중 무엇이 나은가?”, “이 카테고리에서 대안은?” 같은 질문이면 충분하다. 세 AI에 같은 질문을 넣고 답변과 출처를 표에 붙인다. 그중 “이건 우리 이야기가 아닌데?” 싶은 문장 하나를 골라 출처 페이지를 연다.
그 문장을 발견한 순간부터 브랜드 인식은 운이 아니라 작업이 된다. 출처를 고치고, 같은 질문으로 다시 확인하라. 이번 주에 10개 질문을 기록하고, 다음 달에 같은 10개를 다시 실행해라. 도구를 사는 것보다 먼저, AI가 우리 브랜드를 틀리게 말하는 장면을 정기적으로 목격하는 습관을 만들어라. 직접 감사한 결과에서 가장 이상했던 답변을 댓글로 공유하면, 다른 팀이 어떤 질문을 고정해야 할지 함께 배울 수 있다.
근거 출처
이 글의 외부 정보(하베스터 수집): 본문에 사용한 사실과 도구 설명은 아래 외부 자료를 바탕으로 했다. 이 글에는 에이전트-드루 대화나 작업에서 얻은 상호작용 경험을 사실 근거로 사용하지 않았다.
- Semrush, Carlos Silva, How to find and fix what AI gets wrong about your brand (2026-05-08). 원문 — 멀티 플랫폼 감사의 필요성, 오류 유형, 제3자 출처 추적, AI Visibility Toolkit(2억 1,300만 프롬프트), Narrative Drivers·Perception·Visibility 기능, 수정 후 반영까지 걸리는 시간.
- Google Search Central, Organization structured data (2026-04-15 업데이트). 공식 문서 — 홈페이지의 Organization 구조화 데이터, name·url·logo·sameAs 등 권장 속성, 실제 콘텐츠와 일치해야 한다는 원칙.
상용 도구의 기능·프롬프트 데이터베이스 규모는 제공사의 설명을 인용한 것이며, 도구 사용 전 현재 요금제와 지원 플랫폼을 확인해야 한다.